IA en marketing: cómo probar un piloto antes de conectarlo
Un piloto de IA en mercadotecnia necesita una tarea delimitada, casos de prueba y responsables capaces de corregir o detener su uso. Esta guía propone evaluar una ayuda para clasificar consultas de campaña antes de conectarla con clientes. La decisión depende de resultados del piloto, no de una promesa general sobre la tecnología.
Elegir una tarea que permita comprobar el resultado
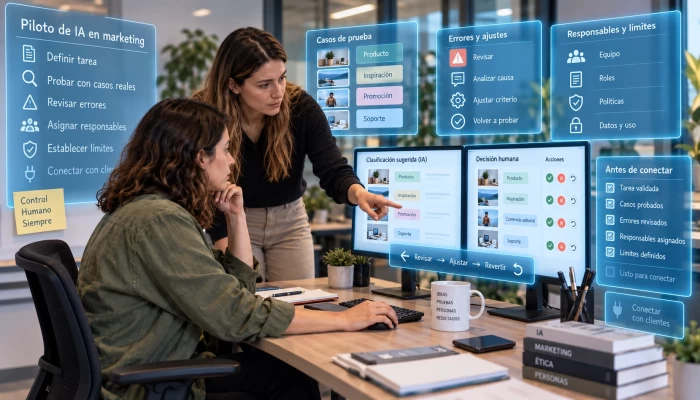
En el ejemplo propuesto, una agencia considera un asistente para clasificar consultas que llegan desde una campaña. La tarea inicial consiste en sugerir si el mensaje corresponde a diseño web, mantenimiento o una pregunta ajena al servicio. No incluye contestar al cliente, cambiar precios ni enviar una propuesta. Delimitar la tarea permite comparar una sugerencia con el trabajo de una persona y observar errores antes de ampliar permisos. El piloto debería poder describirse en una frase que el equipo de atención reconozca y pueda poner a prueba. Cuando este diagnóstico necesita llevarse a implementación, Diseño web, SEO y mercadotecnia permite trabajar el siguiente paso con una ruta concreta y medible.
Registra quién utilizará la sugerencia, qué información necesita y qué decisión conserva. Si una consulta resulta ambigua, define una salida de revisión pendiente en lugar de forzar una categoría. La prueba debe incluir mensajes que mezclen varios servicios y otros que no expliquen lo que la persona necesita. Esas situaciones sirven para descubrir qué hará el sistema cuando no puede resolver su tarea. No presentes una tasa de acierto de un ejemplo sencillo como garantía de que manejará correctamente cualquier conversación que llegue desde una campaña futura. Para ampliar este punto, Cómo puede utilizar inteligencia artificial una pequeña empresa sin complicarse aporta un contexto complementario dentro del mismo recorrido.
El Playbook de NIST propone seleccionar métodos y métricas de medición a partir de los riesgos identificados en el contexto de uso. El Playbook organiza sugerencias alrededor de gobernar, identificar el contexto, medir y gestionar los riesgos de IA. NIST aclara que su Playbook se adapta al caso de uso y no exige seguir todas las sugerencias como una lista universal.
Documentar el contexto y los límites del piloto
Antes de instalar el asistente, describe el recorrido actual de las consultas: dónde llegan, quién las lee y cómo se asignan. Identifica qué paso se espera apoyar y cuáles quedan fuera. Para este ejemplo, conservar la asignación humana permite verificar las sugerencias sin enviarlas automáticamente a departamentos distintos. El equipo debe poder consultar qué clasificación se propuso y cuál aceptó la persona responsable. Si ese registro no existe, será difícil localizar si el problema apareció en la interpretación del mensaje o en una regla de distribución posterior.
Prepara también un inventario de la información utilizada por el piloto. No añadas conversaciones completas por defecto cuando bastaría un texto autorizado y limitado para la prueba. Acuerda con los responsables qué datos pueden utilizarse, dónde se guardan y cuándo dejan de ser necesarios. Esta guía propone preguntas para revisar la operación; no certifica que un proveedor cumpla requisitos específicos ni sustituye la evaluación que corresponda a la organización. La prueba debe realizarse con datos ficticios o con material cuyo uso haya sido autorizado para esa finalidad concreta.
Crear un conjunto de pruebas que incluya fallos
Selecciona consultas que representen el trabajo esperado y anota la respuesta que el equipo considera adecuada. Para la clasificación de servicios, incluye solicitudes claras de un sitio nuevo, problemas de mantenimiento, mensajes incompletos y consultas ajenas al negocio. Mantén separados los ejemplos usados para configurar el piloto y los reservados para evaluarlo. Si sólo vuelves a probar los mensajes que ayudaron a ajustar sus instrucciones, el resultado no explica cómo se comportará ante entradas distintas. Guarda una descripción de cada caso para que otra persona pueda revisar la comparación.
No reduzcas la evaluación a un porcentaje de categorías correctas. Registra también el tipo de error y su consecuencia operativa: una solicitud urgente de mantenimiento enviada al equipo equivocado puede requerir una prioridad diferente a una pregunta general mal clasificada. Es una propuesta para discutir con atención y desarrollo, no una escala universal de riesgos. Define qué resultado obliga a detener la prueba y qué fallo puede corregirse durante el piloto. Las condiciones de aceptación deben establecerse antes de observar los resultados para evitar justificarlos sólo porque parecen convenientes.
Conservar una persona responsable de aceptar la sugerencia
La interfaz del piloto debería permitir reconocer que la clasificación es una sugerencia, ver el mensaje autorizado y elegir una alternativa. Prueba con el equipo si esa revisión añade claridad o crea una confianza excesiva en la salida automática. Un botón de aceptar no demuestra por sí mismo una supervisión útil si la persona no dispone del contexto ni del tiempo para evaluar. Propone observar cómo se resuelven los casos ambiguos y registrar por qué se cambia la sugerencia. Esa información ayuda a localizar patrones que requieren una corrección del piloto.
Para esta fase, evita conectar acciones adicionales sólo porque la clasificación parece funcionar en algunos casos. Asignar responsables, contestar, modificar datos y publicar mensajes son tareas con efectos diferentes. Cada ampliación necesita una descripción y sus propias pruebas. Documenta quién puede aprobar un cambio y cómo se desactiva el asistente si aparece un problema. En el ejemplo, la cola original de consultas debe seguir disponible para atención. Recuperar el recorrido anterior tendría que ser una acción practicable, no una instrucción que nadie probó antes del lanzamiento de la campaña.
Medir el piloto frente al trabajo que se quiere mejorar
Compara resultados con el proceso actual usando el mismo conjunto de casos y las mismas definiciones. Observa errores de clasificación, consultas enviadas a revisión, tiempo de comprobación y correcciones necesarias. Aclara qué cantidad describe cada medición y durante qué periodo se obtuvo. Si el equipo necesita más tiempo para comprobar salidas que para clasificar directamente, registra ese resultado aunque el porcentaje de categorías correctas sea alto. La decisión de continuar debe considerar el recorrido completo y no sólo una respuesta llamativa de la herramienta en una demostración comercial. La referencia original de Investigación de tema aporta el contexto y los límites de estos datos.
Guarda la configuración que produjo cada resultado para poder repetir la prueba después de un cambio. Un ajuste de instrucciones, de categorías o de integración puede modificar el comportamiento observado. Define qué casos deben volver a ejecutarse y conserva los fallos anteriores como parte de la comprobación. No publiques mejoras de productividad si todavía no se midieron en el trabajo autorizado de la agencia. En esta guía, las métricas son propuestas para diseñar una evaluación propia; los resultados de un proveedor o de otra organización no prueban el desempeño del piloto específico.
Decidir la siguiente fase con evidencia y condiciones
El cierre del piloto debe dejar una decisión escrita: continuar con alcance limitado, corregir una condición o volver al proceso anterior. Relaciona esa decisión con los casos y criterios definidos, incluyendo errores sin resolver. Para la campaña del ejemplo, puede resultar razonable conservar la sugerencia únicamente para consultas claras y dejar el resto en revisión. Esa decisión no implica que la tecnología sea adecuada para cualquier servicio ni que deba incorporarse a todos los módulos del CRM. El alcance elegido necesita corresponder con la evidencia disponible y con la capacidad real de supervisión. Para ampliar este punto, IA en sitios web: qué puede automatizar hoy y qué todavía necesita supervisión humana aporta un contexto complementario dentro del mismo recorrido.
Antes de ampliar el piloto, repite una interrupción controlada: desactiva la sugerencia en el entorno de prueba y verifica que atención todavía pueda recibir y clasificar las consultas. Comprueba además qué verá el equipo cuando falta una respuesta o llega un resultado no reconocido. Asigna una fecha para revisar la decisión con nuevos casos autorizados y un responsable para observar fallos. La recomendación final es conservar un recorrido entendible, medible y reversible. Un piloto aprobado es una evaluación concreta que debe mantenerse; no una autorización permanente para actuar automáticamente sobre clientes sin nuevas comprobaciones.
Qué revisar en este caso
- El piloto define una sola tarea y conserva las decisiones fuera de su alcance.
- Los datos utilizados tienen una finalidad autorizada y un responsable de tratamiento.
- Los casos de evaluación incluyen entradas claras, ambiguas y ajenas al servicio.
- Las condiciones de aceptación y de detención se acordaron antes de medir resultados.
- Se registraron errores y tiempo de revisión frente al proceso actual de la agencia.
- El equipo puede desactivar la sugerencia y continuar atendiendo la cola original.
Fuentes consultadas
Editor: Angel G.
Angel G | Un Rino · Diseño web, SEO y mercadotecnia digital.